 НОВОСТИ В УЗБЕКИСТАНЕ

Компания Gorgona исследовала, как языковые модели обрабатывают узбекский. Один и тот же текст на узбекском занимает у крупных провайдеров в 1,55−2,17 раза больше токенов, чем на английском, а значит, и стоит дороже. Переход на новый алфавит дополнительных расходов не потребует, а у части моделей сделает текст немного дешевле.
Одно слово вместо трёх
Kitoblarimizdan по-русски значит «из наших книг», по-английски from our books. Одно узбекское слово передаёт смысл трёх английских: к корню kitob («книга») присоединяются аффиксы множественного числа, принадлежности и направления. Для человека это естественная грамматика. Для нейросети это задача, с которой она справляется не лучшим образом.
Языковые модели читают текст не словами, а токенами, то есть фрагментами, на которые его режет специальная программа, токенизатор. Её словарь собирается из текстов, на которых обучали модель, и целыми токенами становятся те слова и их части, что встречались там часто. Английского в этих данных больше всего, поэтому английское слово обычно занимает один токен. Узбекское распадается на несколько, причём не по смыслу, а по частоте.
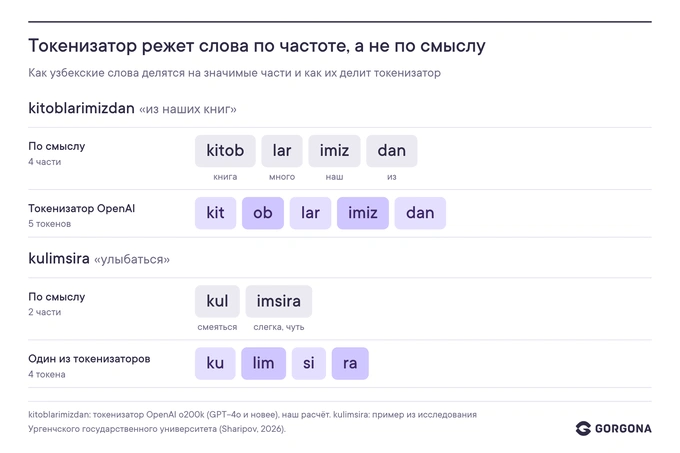
Слово kitoblarimizdan токенизатор OpenAI делит на пять частей, а kulimsira («улыбаться») в одном из токенизаторов распадается на ku, lim, si и ra, и корень kul («смеяться») теряется.
Сколько это стоит
Провайдеры ИИ берут плату за каждый токен по единому тарифу для всех языков. Поэтому чем на большее число частей разбит текст, тем он дороже. Исследователи называют это «налогом на токены».
Gorgona AI проверила 1337 параллельных текстов на 15 токенизаторах. В выборку вошли вики-статьи, новости, устная речь и 299 новостей, изначально написанных по-узбекски. Исследователи отмечают, что качество ответов не было проверено. Эксперты Gorgona AI считают, что этот аспект можно рассмотреть в будущем для более глубокого анализа.
Итог: узбекский текст на латинице занимает в 1,55−2,17 раза больше токенов, чем тот же текст на английском, у всех пяти провайдеров: OpenAI, Anthropic, Google, Qwen и DeepSeek. По сравнению с русским узбекский дороже в 1,24−1,54 раза.
Дело не в числе носителей. На узбекском говорят около 40 миллионов человек, это второй по распространённости тюркский язык после турецкого. Но важно не то, сколько людей говорит на языке, а то, сколько на нём написано в интернете. Турецкий устроен так же, как узбекский, и тоже пишется латиницей, но обходится моделям заметно дешевле: у GPT-4o те же 30 предложений заняли на турецком 609 токенов, а на узбекском 763.
Два алфавита и четыре апострофа
У узбекского есть ещё одна особенность: он живёт сразу в двух алфавитах. С 1940 года язык писался кириллицей, в 1993 году официальной стала латиница, но кириллица по-прежнему широко используется. Для ИИ соотношение двух записей зависит от модели: у Claude они стоят одинаково, у других провайдеров разница составляет 7−23%. Она связана не с устройством кириллицы, а с тем, сколько текстов в каждой записи модели видели при обучении.
В самой латинице есть буквы oʻ и gʻ, а апостроф в них набирают четырьмя разными символами. Для токенизатора каждый из них отдельный знак, а стандартные программы к тому же разрывают на нём слово: oʻzbek превращается в «o», апостроф и «zbek». Один только выбор символа меняет число токенов до 5%.
Новый алфавит: одно слово, одно написание
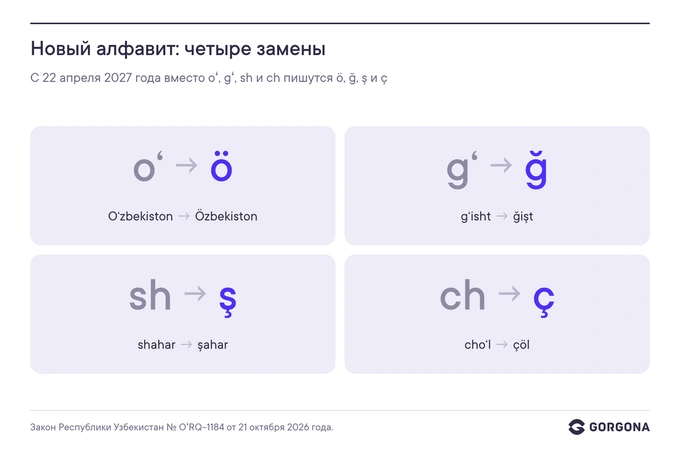
21 октября 2026 года президентом был подписан закон о новом узбекском алфавите. С 22 апреля 2027 года вместо oʻ, gʻ, sh и ch будут писаться ö, ğ, ş и ç. Одной из целей закона названо развитие языка в цифровой среде.
Gorgona проверила, как новая запись скажется на работе ИИ, заменив буквы во всех текстах исследования. Текст становится короче на 4% по числу символов. У трёх из пяти крупнейших провайдеров, Claude, Gemini и Qwen, сокращается и число токенов, на 2−4%. У OpenAI и DeepSeek оно практически не меняется. Иными словами, переход на новый алфавит не потребует от компаний и госорганов дополнительных расходов на ИИ.
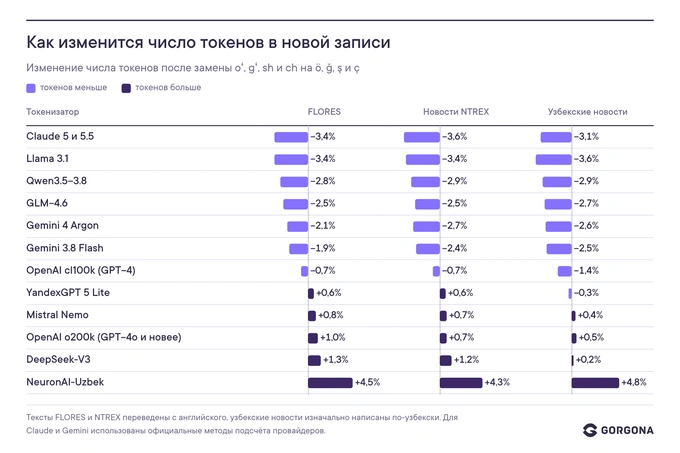
Изменение числа токенов после замены oʻ, gʻ, sh и ch на ö, ğ, ş и ç на трёх корпусах.
Главное преимущество новой записи для цифровой среды в том, что каждое слово получает одно написание: вместе с oʻ и gʻ уйдёт и путаница с апострофом. Независимый замер Дусмамата Каримова на текстах узбекской «Википедии» и новостей Gazeta.uz пришёл к тому же выводу.
Что дальше
Цифровой потенциал нового алфавита раскроется быстрее, если заранее обеспечить его данными. Модели осваивают ту запись, которой больше в сети, поэтому чем раньше там появятся тексты в новом алфавите, тем быстрее нейросети научатся с ними работать. Параллельные корпуса в двух записях, открытые конвертеры и единые правила набора лучше подготовить к апрелю 2027 года.
Шире вывод исследования звучит так: открытые узбекские тексты работают как цифровая инфраструктура. Чем их больше, тем дешевле и, вероятно, качественнее ИИ-сервисы на узбекском для всех, от стартапов до госорганов. Модели, в словарь которых явно заложен узбекский, уже сейчас тратят на него почти столько же токенов, сколько на английский.
Эту работу не сделать в одиночку. Корпуса, морфологические словари, токенизаторы и тесты качества на узбекском под силу только компаниям, университетам и государству вместе, в диалоге с разработчиками моделей.
Полная версия исследования «Один смысл, разная цена. Сколько стоит узбекский язык для ИИ?» опубликована по ссылке.
На правах рекламы.